


1. 适用场景与准备
用于批量清理文本行、替换正文、合并拆分、添加内容、提取号码或链接、模板处理、改名、恢复备份、编码转换与检查。所有文档在本机处理,不上传内容。
使用 Windows 电脑;系统自带的脚本执行组件必须可用,若被单位安全策略禁用,请联系管理员,不要关闭防护软件。
默认导入
.txt;在“配置”中可主动开启.log/.csv/.md/.json/.xml/.bak。必须是纯文本,不能把 Word、PDF、图片或压缩包改后缀后导入。操作前把原文复制到独立备份目录。即使选择另存或自动生成覆盖备份,也必须在提示中点击 “我已备份” 才会分析或处理;取消不会处理文件。
先用少量副本试做,预览符合预期后再批量运行。含账号、手机号或 token 的文件应放在自己有权限访问的目录。
2. 首次操作
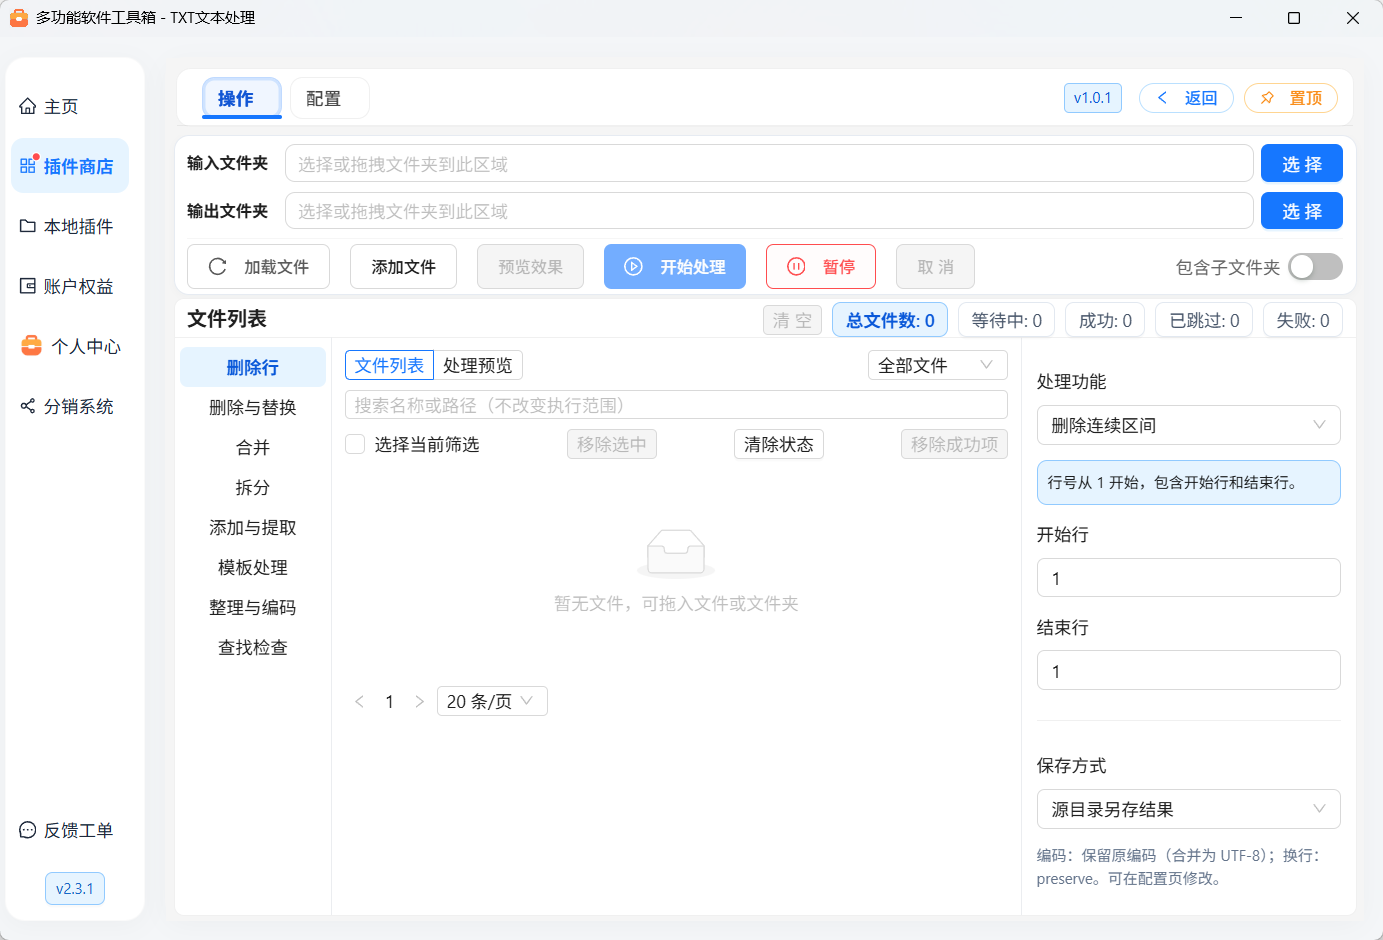
打开“TXT文本处理”,停留在“操作”页。
点击“添加文件”多选,或选择输入文件夹;可把文件、文件夹拖到列表区域。需要多级目录时开启“包含子文件夹”。同一路径不会重复加入。
选择左侧功能分组,再在右侧选择具体处理功能。小窗口使用分组下拉框与“处理参数”抽屉。
填好参数和保存方式。初次建议“指定目录另存结果”,并选择一个独立输出文件夹。
点击“预览效果”,核对文件数、操作和保存位置,点击“我已备份”。预览执行完整分析,但只展示有限样本,不写正式结果。
检查原文与结果样本、预计文件名、空内容提醒及统计。多结果按每页 10 项翻页,每项可以选择查看。
点击“开始处理”,再次核对提示并确认。完成后点击文件项,打开结果或所在目录。
改变文件、参数、保存方式或队列后需重新预览;预览后若原文件或模板被其它程序改写,执行会拒绝旧预览。开始执行后本次预览不再保留,再次处理会重新读取文件并分析;如需先核对效果,请重新预览。不要在处理过程中编辑来源文件。
3. 队列、执行范围与结果
名称/路径搜索、状态筛选和分页只影响显示,不改变执行范围。使用“全部文件”或“勾选文件”明确选择处理范围。
勾选后可移除;选中文件项可上移、下移、置顶、置底。合并使用当前队列顺序。
“清空”“移除选中”“移除成功项”不删除磁盘文件。“清除状态”不恢复文件内容,重做会读取当前磁盘版本。
文件项显示大小、分析后的编码、换行、行数、字符数、状态、错误以及已生成结果。字符数含空格,不含换行;常见 emoji 按一个字符计数。
无论是否先预览,都会完整分析本批次并核对输出名称,通过后才开始写入。分析失败或输出目标冲突时不会写入本批结果;写入阶段失败或取消仍可能保留此前已完成的文件。
暂停在当前文件结束后生效;“正在暂停”表示还没有停稳。继续领取下一项。取消停止未完成任务,已完成结果保留。
返回或关闭沿用工具箱的忙状态确认。一个多结果任务可能已有部分文件提交,失败时这些路径仍会展示;不能假设整批自动撤销。
4. 删除行
空文件为 0 行。a 和以换行结尾的 a 都是一行,额外空白行另算。删除后空内容是有效结果,请特别核对预览提醒。
5. 删除、替换与裁剪
删除指定文本:输入要删除的内容,删除所有命中;可以直接粘贴多行,也可以只输入空格、Tab 或真实换行;完全未输入时不允许处理。
替换文本:普通模式按字面匹配;正则模式可用
$1、$2、${组名}引用捕获内容。例:查找([A-Za-z]+)(\d+)、替换$2:$1,abc12变为12:abc。逐行/整篇:逐行规则不能跨行;整篇允许跨行,最多 32 MiB。普通多行查找也按整篇处理,真实换行可匹配原文的 CRLF、LF 或 CR;替换文本的换行沿用所选输出风格,选择保留时沿用原文风格。正则模式仍按正则规则匹配。输入的字面
\n不自动转换成换行,要直接粘贴真实多行内容。删除行首数字:只删开头连续数字,如
123正文变为正文。删除行首尾字符:两端独立设置;可粘贴样本并点击“填入行首/行尾”计算数量,不会切坏普通 emoji。
清理首尾空白:只清理空格和 Tab,首尾独立开启。
空查找内容会被拒绝。正则非法或超时不会提交正式输出;请简化规则,不要反复使用复杂嵌套重复匹配。
6. 合并
至少导入两个文件,先调整顺序,可编辑结果文件名。
每个文件独立解码。“保留原编码”在合并时输出 UTF-8 无 BOM;也可在配置显式选择其它编码。只有第一个输入项列出共享结果,避免误以为每个来源都生成一个结果。
7. 拆分
拆分以编号后缀命名,预览列出全部预计结果,可翻页。空文件不能拆分。竖向拆列不是完整 CSV 解析:带引号、转义或字段中嵌入换行的复杂 CSV 不适用。输入 Tab 分隔符时应粘贴实际制表符。
8. 添加与提取
添加内容
第一行后插入空白行:空文件会提示不可处理。
文件首尾添加:可粘贴多行文本;“对应区域已存在时跳过”只检查相应首尾,不因正文中间出现就跳过。
每行首尾添加:两端可独立留空。
递增序号:设置起始值和分隔符,不同文件分别从起始值编号。
文件名加入首行:选择不含扩展名、完整文件名或完整路径,可加前后缀。
常用与正则提取
常用类型包含邮箱、QQ 候选、手机号候选、身份证号候选、超链接、完整英文单词,也可选择全部,结果按类型分开。身份证可开启校验位检查,但仍不代表身份真实有效;号码匹配不代表号码存在,链接不会自动访问。
正则提取默认输出完整匹配,可填捕获组编号或名称;整篇模式允许跨行且限制 32 MiB。默认去重并保留首次命中,可以关闭;可每个文件独立输出或勾选汇总,汇总按队列顺序跨文件去重。预览“提取来源”显示前 50 条的来源路径及行列位置,正式文本结果不插入额外来源字段。
手机号与 token 配对
默认同一行是一条记录,填写字段名(如
token或access_token)。例如13800138000 token=abc得到手机号和对应 token 两列。多候选无法唯一配对时记为歧义,不猜最近出现的号码,不跨文件配对。
自定义规则必须使用
phone、token命名捕获组;多行记录必须显式提供整篇规则,例如(?<phone>1[3-9]\d{9})\s+token=(?<token>[^\s]+)。TSV 结果默认以“手机号 + token”组合去重。token 默认遮罩,主动点击“显示 token”才在当前样本展开,切换结果、翻页、隐藏或重新预览后恢复遮罩,之前的查看请求不会展开其它结果。实际结果文件包含原始 token,请妥善保存。
手机号、实际 token、正文和规则不保存到配置,不写入操作日志。
9. 模板处理
模板是只读纯文本文件,在参数中选择。
模板替换指定区间:包含开始/结束行,用模板内容整体替换该段,区间外不变。
模板插入:选择文件首、文件尾、指定行前或后,指定行必须存在。
模板关键词提取:模板一行一个关键词,默认命中任意关键词就保留该原文行;一行命中多个词只输出一次。可要求全部词并选择忽略大小写。
模板内容块分发:默认以
TRANS开始、CALL结束,结束行用完整目标文件名(不含扩展名)作匹配键,键前后不能粘着字母、数字或下划线。默认保留开始行、不保留结束行,可调整。示例:目标订单01.txt,模板含TRANS、正文、CALL 订单01,输出对应块;多个块按模板顺序汇总。
缺开始/结束、嵌套开始、同一行有双标记、结束行目标歧义或找不到目标时明确失败,不截取半段,也不把 订单01 误配到 订单010。
10. 整理、编码与查找
普通 .bak 恢复去掉 .bak 后缀,例如 文章.txt.bak 对应 文章.txt;没有原扩展名时恢复副本使用 .txt。不要把名称相同当作来源正确的证明,应先核对备份内容。
11. 保存和配置
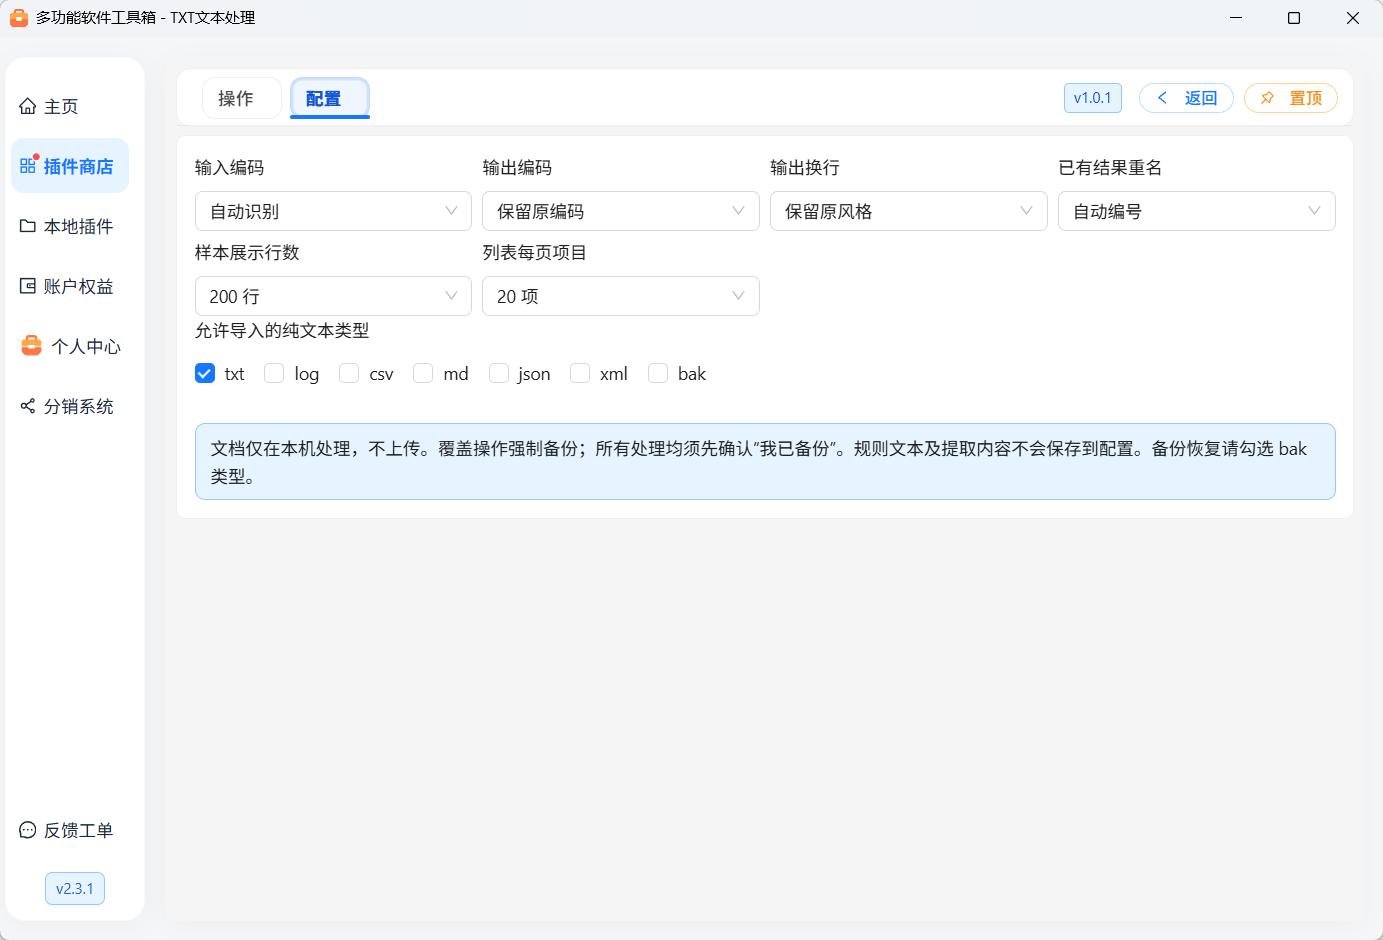
“自动编号”同时避让已有文件和本批次其它结果。若使用“跳过”或“覆盖并备份”,而本批多个结果仍指向同一路径,整批会在写入前停止;请改用自动编号、调整输出目录或分批处理,不会用后一个结果覆盖前一个。
配置支持输入自动识别或手动 UTF-8、UTF-8 BOM、UTF-16 LE/BE、GBK、GB18030、Big5;输出可保留或显式指定。BOM 优先;识别不可靠时请手动选择正确来源,不要用输出编码去“猜”输入。混合换行修改通常需明确选择 CRLF/LF,不静默统一;仅修正文件尾时可以保留正文的混合换行。
样本行数可选 50/100/200;每个结果样本最多 4 KiB,原文最多 8 KiB,截断提示不代表正式输出缺失。列表页大小 10/20/50/100。配置只保存路径、类型和非敏感偏好,不保存文档、提取内容或本次规则。重开插件或切换功能后,若此前保存方式不再适用,会改回“源目录另存结果”,请在确认窗口核对。覆盖备份强制启用,不能关闭。
12. 常见问题与限制
按钮不可用:先加载文件,等待在途分析结束;合并至少两个文件,“勾选文件”范围需有勾选项。
乱码/编码歧义:先用能正确打开原文的软件确认来源编码,在配置手动指定,再用副本预览。已存在 BOM 的文件以 BOM 为准。
越界或模板错误:按原文行数调整区间,检查模板标记配对及目标名称,不用倒序范围表示插入。
拒绝链接/联接:使用普通文件与目录;插件拒绝符号链接、目录联接和多重硬链接文件,防止误改别处。
只读、被占用、空间不足:关闭占用程序、选择可写目录、预留足够空间后重试;不要删除未核对的原文或备份。排序、去重和完整分析会使用额外磁盘空间。
大文件:逐行能力不等于无限文件大小;整篇正则、普通多行替换及模板读取最多 32 MiB,超过须拆分或选择逐行方式。大文件/大量文件先预览小样本,处理速度取决于磁盘和内容。
失败或取消后:查看每项错误和已经生成的结果,原始输入默认未改;覆盖/改名模式用保留的备份恢复。不要认为“清除状态”会恢复文件。